Python Pytorch 강좌 : 제 11강 - 데이터 세트 분리(Data Set Split)
데이터 세트 분리(Data Set Split)
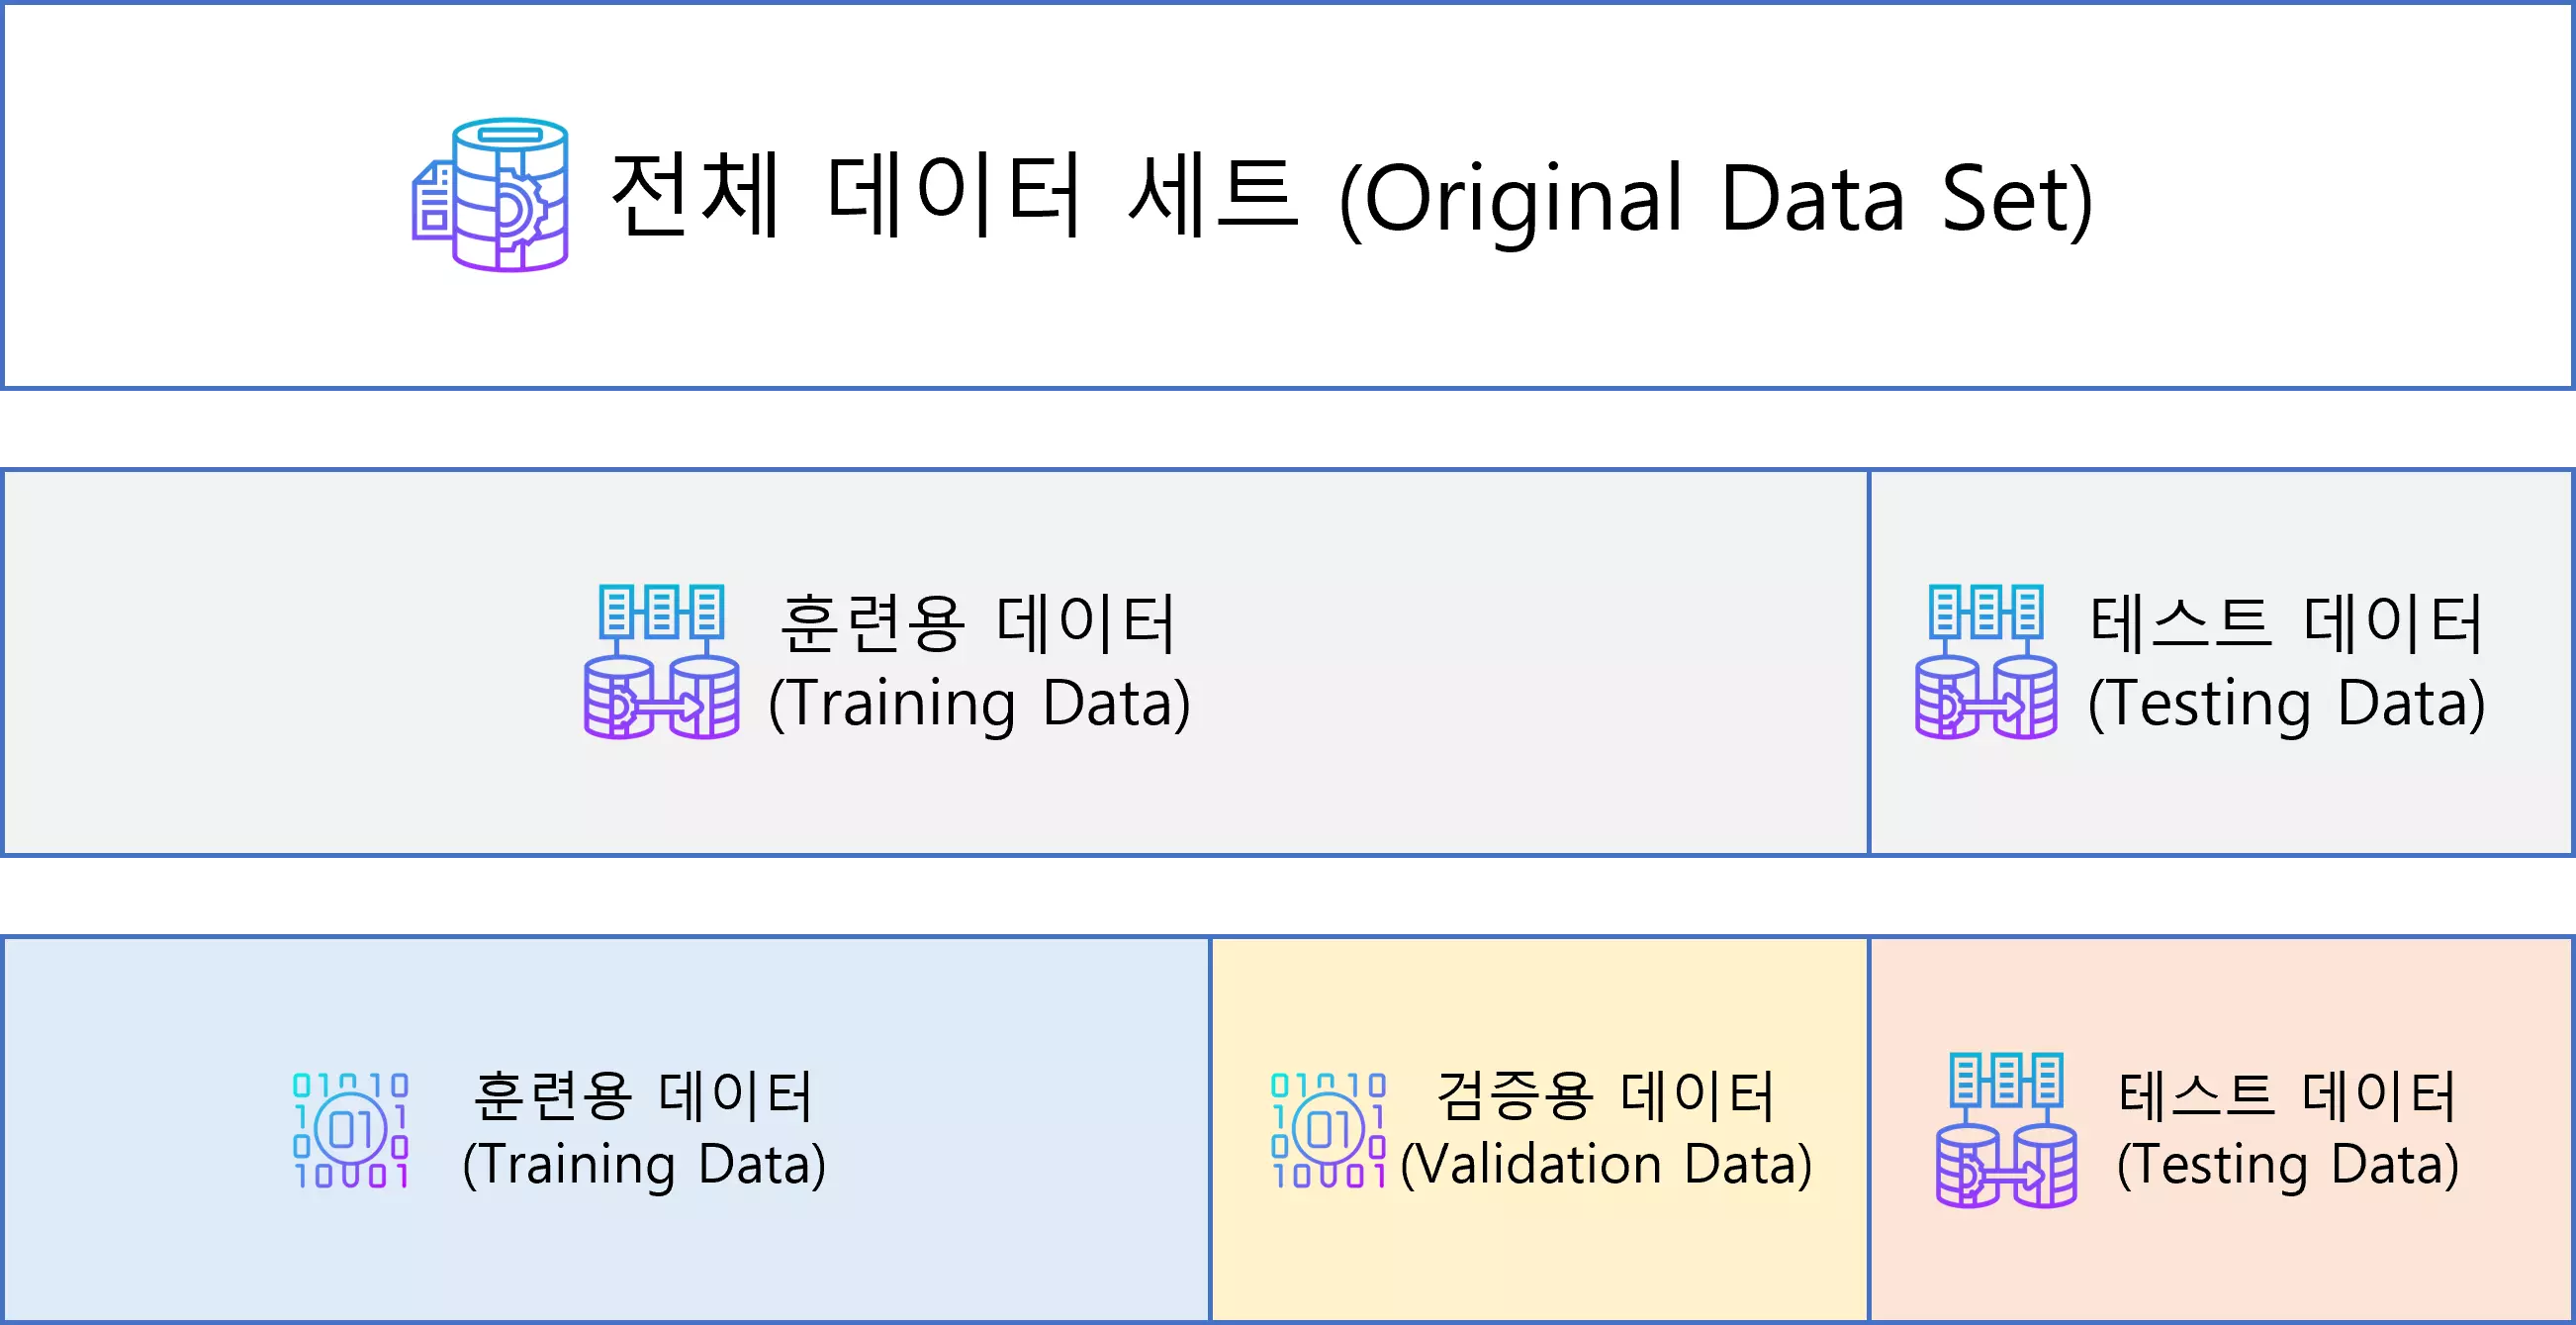
인공 신경망(Neural Network)에 사용되는 데이터 세트는 크게 세 가지가 사용됩니다.
전체 데이터 세트(Original Data Set)을 세 가지 목적으로 분류하여 사용됩니다.
전체 데이터 세트는 훈련용 데이터(Training Data), 검증용 데이터(Validation Data), 테스트 데이터(Testing Data)로 분류됩니다.
훈련용 데이터(Training Data)
훈련용 데이터(Training Data)는 모델(Model)을 학습하는 데 사용되는 데이터 세트입니다.
지금까지는 전체 데이터 세트(Original Data Set)를 그대로 사용하여 학습시키고 임의의 값을 입력하여 검증하거나 테스트를 진행하였습니다.
하지만, 이러한 방법은 모델을 평가하는데 적합한 방법이 아닙니다.
그러므로, 목적에 따라 데이터 세트를 분리하여 검증과 테스트를 진행합니다.
검증용 데이터(Validation Data)
검증용 데이터(Validation Data)는 학습이 완료된 모델을 검증(Validation)하기 위해 사용되는 데이터 세트입니다.
서로 다른 모델을 사용했을 때 성능 비교를 하기 위해 사용되는 데이터 세트입니다.
또한 모델의 계층(Layer)이 다르거나 에폭(Epoch)이나 학습률(Learning Rate)과 같은 하이퍼 파라미터(HyperParameter)에 따라 학습 결과가 달라질 수 있는 것을 확인했습니다.
이러한 계층이나 하이퍼 파라미터의 차이 등으로 인한 성능을 비교하기 위해 사용됩니다.
테스트 데이터(Testing Data)
테스트 데이터(Testing Data)는 검증용 데이터(Validation Data)를 통해 결정된 성능이 가장 우수한 모델을 최종 테스트 하기 위한 목적으로 사용되는 데이터 세트입니다.
앞선 검증용 데이터에 선택된 모델은 검증용 데이터에 과대적합(Overfitting)된 모델이거나, 검증용 데이터가 해당 모델에 적합한 형태의 데이터만 모여있을 수 있습니다.
그러므로, 기존 과정에서 평가해보지 않은 새로운 데이터인 테스트 데이터로 최종 모델 성능 평가를 진행하게 됩니다.
즉, 훈련용 데이터(Training Data)는 모델 학습을 위한 데이터 집합, 검증용 데이터(Validation Data)는 모델 선정을 위한 데이터 집합, 테스트 데이터(Testing Data)는 최종 모델의 성능을 평가하기 위한 데이터 집합으로 볼 수 있습니다.
전체 데이터 세트(Original Data Set)에서 각각의 데이터 집합으로 분리하는 비율은 일반적으로 6:2:2를 사용하지만, 현재 가지고 있는 데이터 세트의 크기에 따라 조정해서 사용합니다.
데이터 세트
이번 강좌에서는 제 9강 - 모델(Model)에서 사용한 dataset.csv를 그대로 사용합니다.
Dataset 다운로드: 다운로드
dataset.csv는 x, y 두 개의 열로 구성된 200개의 데이터이며, \(y = 3.1x^2 - 1.7x + \text{random}(0.01, 0.99)\)의 관계를 갖습니다.
이 데이터를 8:1:1 비율로 분리하여 비선형 회귀(Nonlinear Regression) 모델을 학습하고 검증하도록 하겠습니다.
메인 코드
import torch
import pandas as pd
from torch import nn
from torch import optim
from torch.utils.data import Dataset, DataLoader, random_split


class CustomDataset(Dataset):
    def __init__(self, file_path):
        df = pd.read_csv(file_path)
        self.x = df.iloc[:, 0].values
        self.y = df.iloc[:, 1].values
        self.length = len(df)

    def __getitem__(self, index):
        x = torch.tensor([self.x[index] ** 2, self.x[index]], dtype=torch.float32)
        y = torch.tensor([self.y[index]], dtype=torch.float32)
        return x, y

    def __len__(self):
        return self.length


class CustomModel(nn.Module):
    def __init__(self):
        super().__init__()
        self.layer = nn.Linear(2, 1)

    def forward(self, x):
        x = self.layer(x)
        return x


torch.manual_seed(42)

dataset = CustomDataset("./dataset.csv")
dataset_size = len(dataset)
train_size = int(dataset_size * 0.8)
validation_size = int(dataset_size * 0.1)
test_size = dataset_size - train_size - validation_size

generator = torch.Generator().manual_seed(42)
train_dataset, validation_dataset, test_dataset = random_split(
    dataset, [train_size, validation_size, test_size], generator=generator
)

print(f"Training Data Size : {len(train_dataset)}")
print(f"Validation Data Size : {len(validation_dataset)}")
print(f"Testing Data Size : {len(test_dataset)}")

train_dataloader = DataLoader(train_dataset, batch_size=16, shuffle=True, drop_last=True)
validation_dataloader = DataLoader(validation_dataset, batch_size=4, shuffle=False)
test_dataloader = DataLoader(test_dataset, batch_size=4, shuffle=False)

device = torch.accelerator.current_accelerator().type if torch.accelerator.is_available() else "cpu"
model = CustomModel().to(device)
criterion = nn.MSELoss()
optimizer = optim.SGD(model.parameters(), lr=0.0001)

for epoch in range(10000):
    model.train()
    cost = 0.0

    for x, y in train_dataloader:
        x = x.to(device)
        y = y.to(device)

        output = model(x)
        loss = criterion(output, y)

        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        cost += loss.item()

    cost = cost / len(train_dataloader)

model.eval()
with torch.inference_mode():
    for x, y in validation_dataloader:
        x = x.to(device)
        y = y.to(device)

        outputs = model(x)
        print(f"X : {x}")
        print(f"Y : {y}")
        print(f"Outputs : {outputs}")
        print("--------------------")

    test_cost = 0.0
    for x, y in test_dataloader:
        x = x.to(device)
        y = y.to(device)

        outputs = model(x)
        test_cost += criterion(outputs, y).item()

print(f"Test Cost : {test_cost / len(test_dataloader):.3f}")- 결과
- Training Data Size : 160
Validation Data Size : 20
Testing Data Size : 20
X : tensor([[43.5600, 6.6000],
[81.0000, 9.0000],
[ 8.4100, 2.9000],
[54.7600, -7.4000]])
Y : tensor([[124.0700],
[236.7600],
[ 21.1800],
[183.2400]])
Outputs : tensor([[124.2954],
[236.2824],
[ 21.6199],
[182.8388]])
--------------------
{중략}
X : tensor([[31.3600, 5.6000],
[18.4900, 4.3000],
[29.1600, 5.4000],
[22.0900, 4.7000]])
Y : tensor([[88.2700],
[50.0800],
[81.9000],
[61.0100]])
Outputs : tensor([[88.1748],
[50.4875],
[81.6947],
[60.9676]])
--------------------
Test Cost : 0.094
- Tip : 결과는 CPU에서 실행한 값입니다. GPU 등 가속기에서 실행하면 텐서 출력에
device='cuda:0'과 같은 장치 정보가 함께 표시되며, 연산 장치에 따라 소수점 아래 값이 조금 다를 수 있습니다.
세부 코드
from torch.utils.data import Dataset, DataLoader, random_split데이터 세트를 분리하기 위해 torch.utils.data에서 random_split 함수를 포함시킵니다.
torch.manual_seed(42)torch.manual_seed로 난수 시드를 고정합니다.
모델 가중치의 초기값과 데이터 로더(DataLoader)의 shuffle=True에 사용되는 난수가 고정되므로, 같은 환경에서는 매번 같은 학습 결과를 얻을 수 있습니다.
dataset = CustomDataset("./dataset.csv")
dataset_size = len(dataset)
train_size = int(dataset_size * 0.8)
validation_size = int(dataset_size * 0.1)
test_size = dataset_size - train_size - validation_size
전체 데이터 세트(dataset)에서 훈련용 데이터(Training Data), 검증용 데이터(Validation Data), 테스트 데이터(Testing Data)를 8:1:1 비율로 분리하도록 하겠습니다.
각각 분리한 데이터 세트들의 합은 전체 데이터 세트의 크기와 동일해야 하므로, 정수형(int)으로 변환하여 계산합니다.
훈련용 데이터 크기(train_size)는 약 80% 비율, 검증용 데이터 크기(validation_size)는 약 10% 비율, 테스트 데이터 크기(test_size)는 나머지 크기(약 10%)로 할당합니다.
generator = torch.Generator().manual_seed(42)
train_dataset, validation_dataset, test_dataset = random_split(
    dataset, [train_size, validation_size, test_size], generator=generator
)

print(f"Training Data Size : {len(train_dataset)}")
print(f"Validation Data Size : {len(validation_dataset)}")
print(f"Testing Data Size : {len(test_dataset)}")
데이터 세트 분리(random_split) 함수를 사용하여 데이터 세트를 분리합니다.
split_dataset = torch.utils.data.random_split(dataset, lengths, generator)은 전체 데이터 세트(dataset)를 분할 크기(lengths)로 나눈 분리된 데이터 세트(split_dataset)를 반환합니다.
분할 크기(lengths)의 길이와 동일한 개수의 분리된 데이터 세트(split_dataset)가 생성되며, 각 데이터 세트는 Subset 클래스로 반환됩니다.
분리된 데이터 세트는 무작위로 분할되어 반환됩니다.
생성자(generator)에 시드를 고정한 torch.Generator를 전달하면, 실행할 때마다 항상 같은 방식으로 데이터 세트가 분리됩니다.
분리 결과가 실행마다 달라지면 모델 간 성능 비교가 어려워지므로, 검증 목적으로 데이터를 나눌 때는 생성자를 고정하는 것이 좋습니다.
- Tip :
분할 크기(lengths)에는[0.8, 0.1, 0.1]처럼 합이 1이 되는 비율을 전달할 수도 있습니다. 이 경우 각 크기는floor(비율 × 전체 크기)로 계산되며, 남는 데이터는 앞쪽 데이터 세트부터 하나씩 배분됩니다.
train_dataloader = DataLoader(train_dataset, batch_size=16, shuffle=True, drop_last=True)
validation_dataloader = DataLoader(validation_dataset, batch_size=4, shuffle=False)
test_dataloader = DataLoader(test_dataset, batch_size=4, shuffle=False)
모든 데이터 세트에 데이터 로더(DataLoader)를 적용합니다.
데이터 로더에 사용되는 매개 변수는 동일하게 설정하지 않아도 됩니다.
훈련용 데이터는 학습 효과를 위해 shuffle=True로 순서를 섞지만, 검증용 데이터와 테스트 데이터는 순서를 섞을 필요가 없습니다.
또한 평가에서는 모든 데이터를 사용해야 하므로 drop_last=True를 적용하지 않습니다.
device = torch.accelerator.current_accelerator().type if torch.accelerator.is_available() else "cpu"torch.accelerator 모듈로 현재 환경에서 사용할 수 있는 가속기를 확인합니다.
CUDA, MPS(Apple Silicon), XPU(Intel GPU) 등 사용 가능한 가속기가 있다면 해당 장치의 이름("cuda", "mps", "xpu" 등)을, 없다면 "cpu"를 할당합니다.
for epoch in range(10000):
    model.train()
    cost = 0.0

    for x, y in train_dataloader:
        ...
        cost += loss.item()
모델 학습에서는 훈련용 데이터(train_dataloader)를 사용하여 학습을 진행합니다.
model.train()은 모델을 학습 모드로 전환합니다. 검증 과정에서 model.eval()로 전환한 뒤 다시 학습하는 경우를 대비해 에폭마다 호출합니다.
비용을 누적할 때는 loss.item()으로 파이썬 숫자를 꺼내서 더합니다. loss 텐서를 그대로 더하면 불필요하게 연산 그래프가 유지됩니다.
model.eval()
with torch.inference_mode():
    for x, y in validation_dataloader:
        x = x.to(device)
        y = y.to(device)

        outputs = model(x)
        print(f"X : {x}")
        print(f"Y : {y}")
        print(f"Outputs : {outputs}")
        print("--------------------")
모델 검증 과정에서는 검증용 데이터(validation_dataloader)로 검증을 진행합니다.
model.eval()은 모델을 평가 모드로 전환합니다. 드롭아웃(Dropout)이나 배치 정규화(Batch Normalization)처럼 학습과 추론에서 동작이 다른 계층이 추론 방식으로 동작합니다.
torch.inference_mode()는 torch.no_grad()처럼 기울기 계산을 비활성화하며, 추론에 필요하지 않은 추적 작업까지 생략해 더 효율적으로 동작합니다.
여러 모델들로 검증을 진행하며, 이 결과에서 우수한 성능을 내는 모델을 결정합니다.
    test_cost = 0.0
    for x, y in test_dataloader:
        x = x.to(device)
        y = y.to(device)

        outputs = model(x)
        test_cost += criterion(outputs, y).item()

    print(f"Test Cost : {test_cost / len(test_dataloader):.3f}")
모델이 결정되면 최종 평가를 위해 테스트 데이터(test_dataloader)로 테스트를 진행합니다.
테스트 데이터는 학습과 모델 선정에 한 번도 사용되지 않은 데이터이므로, 이 비용이 모델의 최종 성능 지표가 됩니다.
예제에서는 테스트 데이터의 평균 제곱 오차(MSE)가 0.094로 계산되었습니다.
공유하기
 Naver
X
LinkedIn
Facebook
댓글 남기기